
IA para networking: mitos e realidade
De facto, muitas aplicações de networking dizem oferecer AI matchmaking ou smart networking, mas por trás disso podem estar níveis muito diferentes de inteligência real - desde uma simples ordenação por etiquetas até recomendações verdadeiramente adaptativas com elementos de aprendizagem automática.
Vamos analisar por níveis - do mais simples ao mais avançado, com exemplos de fórmulas e lógica possíveis.
🧩 1. "IA" ao nível da filtragem e da interseção de etiquetas (90% dos casos reais)
Como funciona:
-
Os participantes indicam interesses, setor, cargo, objetivos (por exemplo, "procuro parceiros no fintech").
-
O algoritmo simplesmente conta o número de coincidências de etiquetas ou categorias.
A fórmula pode ser:
$$\text{score}(A,B) = \frac{|T_A \cap T_B|}{|T_A \cup T_B|}$$
onde \(T_A,\,T_B\) são os conjuntos de interesses dos participantes \(A\) e \(B\).
Em seguida, ordenação por score e apresentação das "top 5" recomendações.
O que é chamado de
"IA":
– "Semantic matching" (mas na realidade é apenas sinonímia de etiquetas via Word2Vec ou GloVe)
– "Interest similarity" (por embedding de palavras de interesse)
👉 Realidade: o algoritmo funciona de forma estável, mas não é "inteligente" - apenas cruza campos.
🤖 2. Algoritmos "Smart" baseados em embeddings (Embedding-based similarity)
Como funciona:
-
Cada participante é representado como um vetor de características (skills, objetivos, descrição do perfil, empresa, temas).
-
Um modelo (por exemplo, Sentence-BERT) converte o texto do perfil num espaço numérico.
-
Depois procuram-se os mais próximos por semelhança de cosseno.
Fórmula:
$$\text{similarity}(A,B) = \frac{v_A \cdot v_B}{\|v_A\| \, \|v_B\|}$$
(semelhança de cosseno entre vetores de embedding)
Vantagem: Permite encontrar
pessoas "semanticamente próximas", mesmo que não usem as mesmas palavras.
Desvantagem: Requer textos adequados e capacidade
computacional.
🧠 3. "Behavioral AI-matching" (menos comum)
Como funciona:
-
O sistema recolhe o comportamento do utilizador: com quem interagiu, a quem deu "like", a quem ignorou, que reuniões confirmou.
-
Depois treina um modelo de recomendação (como a Netflix):
-
Collaborative filtering (utilizadores semelhantes - recomendações semelhantes)
-
Ou Reinforcement learning (otimização com base em métricas de resposta)
-
Fórmula (exemplo de fatorização matricial):
$$\hat{r}_{ij} = p_i^{T} q_j$$
onde \(p_i\) é o vetor de preferências do utilizador \(i\), e \(q_j\) é o vetor de características de outro participante.
Quanto maior \(\hat{r}_{ij}\), maior a "compatibilidade".
Realidade: É um caso muito raro, porque é preciso muitos dados para que isto funcione.
🎩 4. "Magia de marketing"
Algumas plataformas simplesmente fazem:
-
Uma seleção aleatória de quem ainda não te viu;
-
Ou filtram por cidade/setor;
-
E acrescentam "AI powered" na descrição da funcionalidade.
Verificação simples:
– Se a interface não permite indicar objetivos/interesses ou não recolhe dados de interações -
então a "IA" é fictícia.
– Se as recomendações são sempre padronizadas e repetitivas - provavelmente é um simples filtro de etiquetas.
💡 Exemplos de plataformas reais:
| Plataforma | O que dizem oferecer | O que é na realidade |
|---|---|---|
| Brella | AI matchmaking | Tag overlap + Semantic matching |
| Grip | AI-powered networking | Embeddings + Interest weighting |
| Swapcard | Smart recommendations | Tag matching + Simple ML weighting |
| MeetingMojo / Whova | Smart search | Filtragem e ordenação |
| Zerista / Bizzabo | Intelligent matches | Sistema misto (etiquetas + análise de texto) |
AI-matching para conferências - documentação técnica
Compilado a partir da descrição da arquitetura, dos algoritmos e da API, que demonstram uma implementação realista de smart‑matching para uma aplicação de conferências.
Resumo
- Níveis de implementação da "IA": desde etiquetas simples até modelos comportamentais.
- Fórmula híbrida de pontuação e sinais concretos (tag, embedding, role, goal, behavior).
- Pseudocódigo de implementação e exemplo numérico do cálculo do score.
- Esquema da BD (PostgreSQL), tabelas e endpoints da API.
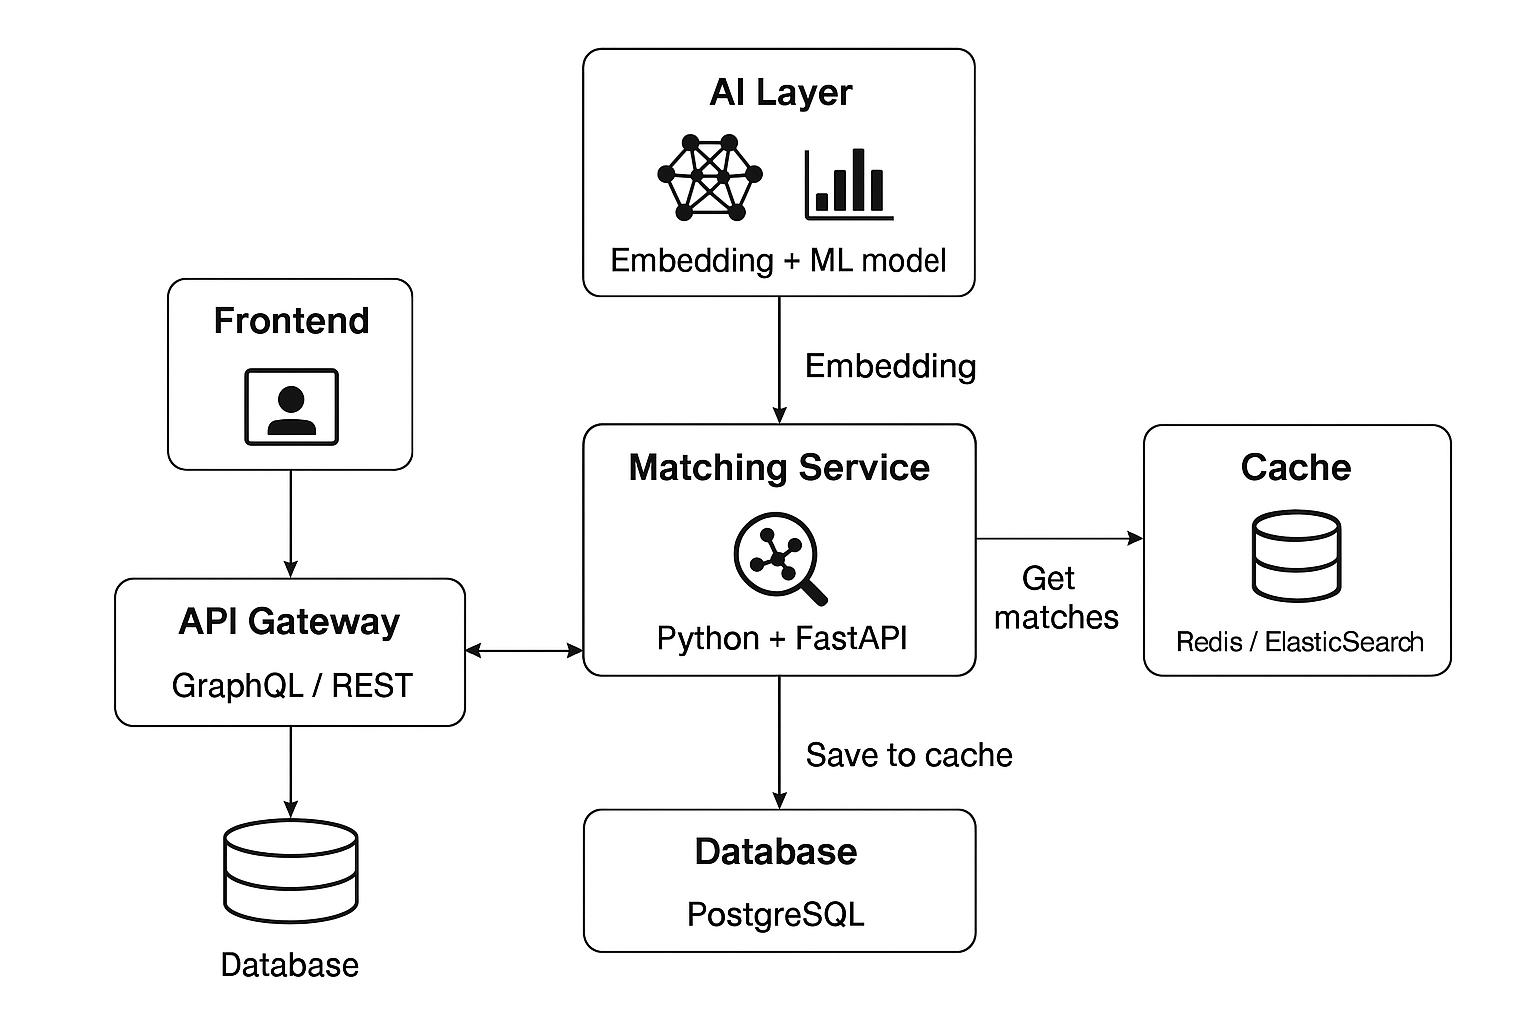
- Arquitetura: Matching Service, AI Layer (embeddings + FAISS) e cache.
1. Níveis de "IA" em aplicações de networking
Segue-se um resumo dos níveis realistas encontrados entre os fornecedores:
1. Filtragem / interseção de etiquetas
Uma das abordagens mais comuns: os participantes indicam etiquetas/interesses; a plataforma conta as coincidências (por exemplo, Jaccard) e ordena por esse indicador.
Fórmula (Jaccard): S_tag = |T_A ∩ T_B| / |T_A ∪ T_B|
2. Embeddings e semelhança de cosseno
Os perfis são convertidos num espaço vetorial (Sentence‑BERT, USE) e procuram-se os vizinhos mais próximos pela medida de cosseno.
Fórmula: S_embed = (v_A · v_B) / (||v_A|| ||v_B||)
3. Modelos comportamentais
Utilizam dados de interações (likes, reuniões, visualizações) e constroem collaborative filtering, fatorização matricial ou graph embeddings.
Requer um volume de dados suficiente, por isso é menos comum.
4. "Magia de IA" de marketing
Algumas plataformas simplificam - usam aleatoriedade ou filtragem pura, mas rotulam a funcionalidade como "IA". Verificar através da interface e da presença de sinais de texto/comportamento.
2. Fórmula híbrida de pontuação (conceito)
Combinamos os sinais com pesos. Fórmula geral:
Aqui σ é a normalização (por exemplo, sigmoide) para colocar o resultado em (0,1).
Sinais (descrição)
- \(S_{\text{tag}}\) - semelhança por etiquetas (Jaccard ou weighted overlap);
- \(S_{\text{embed}}\) - semelhança de cosseno dos embeddings (normalizada em [0,1]);
- \(S_{\text{role}}\) - matriz de compatibilidade de funções (por exemplo, founder ↔ investor = 0,9);
- \(S_{\text{goal}}\) - coincidência de objetivos (procuro / ofereço);
- \(S_{\text{behavior}}\) - collaborative signal (quem deu like/marcou reuniões com utilizadores semelhantes);
- \(C_{\text{conflict}}\) - penalizações (por exemplo, mesmo e-mail/empresa → exclusão ou forte penalização);
3. Fórmulas concretas dos sinais
3.1 Tag similarity (Jaccard)
$$S_{\text{tag}}(A, B) = \frac{|T_A \cap T_B|}{|T_A \cup T_B|}$$
3.2 Embedding similarity (cosine)
$$S_{\text{embed}}(A, B) = \frac{v_A \cdot v_B}{\|v_A\| \, \|v_B\|}$$
Valor em [-1,1] → normalizado em [0,1] como (x+1)/2.
3.3 Role compatibility
Matriz de compatibilidade de funções: tabela de valores predefinida no intervalo [0,1].
3.4 Goal match
Lógica simples de correspondência de objetivos (por exemplo, "procuro parceiros" vs "ofereço parceria" → 1,0).
3.5 Behavioral signal
Exemplo: uso de informação sobre que perfis foram escolhidos por utilizadores semelhantes.
Assinatura mais simples: $$S_{\text{behavior}}(A, B) = \frac{\#\,\text{users similar to } A \text{ who connected to } B}{\#\,\text{users similar to } A}$$
4. Normalização e combinação
Cada sinal é normalizado em [0,1]. Depois combinamos por pesos e aplicamos normalização sigmoide:
$$ \text{raw} = \sum_i w_i S_i - w_6 C $$
$$ \text{score} = \text{sigmoid}\left( \alpha \cdot (\text{raw} - \beta) \right) $$
5. Exemplo numérico
Seja:
- \(T_A = \{\text{fintech}, \text{payments}, \text{API}\}\)
- \(T_B = \{\text{payments}, \text{banking}\}\)
- \(S_{\text{tag}} = \frac{|T_A \cap T_B|}{|T_A \cup T_B|} = \frac{1}{4} = 0.25\)
- \(\text{cosine}(v_A, v_B) = 0.6 \Rightarrow S_{\text{embed}} = \frac{0.6 + 1}{2} = 0.8\)
- \(S_{\text{role}} = 0.7,\; S_{\text{goal}} = 1.0,\; S_{\text{behavior}} = 0.0,\; C_{\text{conflict}} = 0\)
Pesos: \(w_{\text{tag}}=0.15,\; w_{\text{embed}}=0.35,\; w_{\text{role}}=0.15,\; w_{\text{goal}}=0.25,\; w_{\text{behavior}}=0.05\)
\[ \text{raw} = 0.15 \cdot 0.25 + 0.35 \cdot 0.8 + 0.15 \cdot 0.7 + 0.25 \cdot 1.0 + 0.05 \cdot 0 = 0.6725 \] \[ \text{score} = \sigma(8 \cdot (0.6725 - 0.5)) \approx \sigma(1.38) \approx 0.8 \]
Total: B é um excelente candidato (\(\text{score} \approx 0.8\)).
6. Práticas e melhorias
- Cold start: perfis populares + sinais content-only.
- Treino dos pesos: testes A/B e supervised learning (regressão logística, LightGBM) com base em rótulos de utilidade.
- Velocidade: pré-calcular embeddings, ANN (FAISS/pgvector) → candidate generation + re-rank.
- Interpretabilidade: mostrar o motivo do match na interface (etiquetas comuns, coincidência de objetivos).
- Privacidade: opções de "não participar", indicação explícita de que dados são usados.
7. Endpoints da API (REST)
GET /api/users/{id}- perfil e etiquetas.POST /api/users- criação/atualização de perfil (desencadeia a geração do embedding).GET /api/matching/{user_id}- devolve o top‑N de interlocutores recomendados (parâmetro refresh para recalcular).GET /api/matching/search- pesquisa de candidatos por filtros (tags, roles, location).POST /api/interactions- registo de like/skip/meeting_confirmed (feedback para o modelo).
8. Arquitetura e fluxo de dados
Resumidamente: Frontend ↔ API Gateway ↔ Matching Service ↔ Database / AI Layer / Cache.
Diagrama de arquitetura
Fluxograma atualizado: Matching Service, AI Layer (embeddings + ML), DB, Cache.
9. Pipeline de ML em background
- daily_batch.py - recolhe interactions, atualiza os latent vectors.
- retrain_embeddings.py - regeneração dos embeddings após mudança de modelo.
- generate_faiss_index.py - constrói o índice ANN para consultas top‑N rápidas.
10. Recomendações para MVP e escalabilidade
- Começar com etiquetas + Jaccard → adicionar embeddings (Sentence‑BERT) → ANN (FAISS) + re‑rank.
- Cache de matches de 1 a 3 horas para reduzir a carga.
- Para 50 mil participantes - pgvector + Redis; >100 mil - FAISS/Milvus.
E o formato se fôssemos um serviço comum para marketeers e utilizadores em geral:
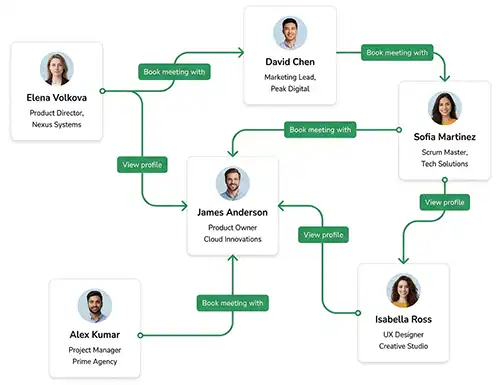
recolha de dados
Recolha dos interesses e preferências dos participantes
Para gerar recomendações de perfil relevantes é necessário um grande volume de dados. Os participantes recolhem estes dados de forma natural ao preencherem os seus perfis e ao simplesmente usarem a plataforma
- Os participantes visitam os perfis uns dos outros e contactam-se através de mensagens e pedidos de reunião
- Isto deixa um rasto de ligações e cria uma rede complexa de interações entre participantes
- Juntamente com os dados dos seus perfis, esta informação é transmitida continuamente ao nosso algoritmo de aprendizagem automática quase em tempo real
análise de dados
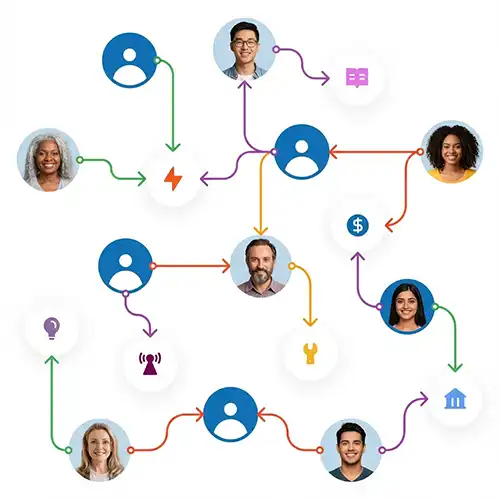
Compreender as necessidades dos participantes com aprendizagem automática
Ao mesmo tempo que recolhe os dados, o algoritmo processa-os. Este ciclo contínuo permite-lhe descobrir o que interessa a cada participante
- O algoritmo analisa continuamente o comportamento dos participantes e a informação dos seus perfis
- Isto é a interpretação dos dados para compreender os interesses e objetivos de cada participante
- Depois de compreender isto, consegue prever que perfis podem interessar ao participante
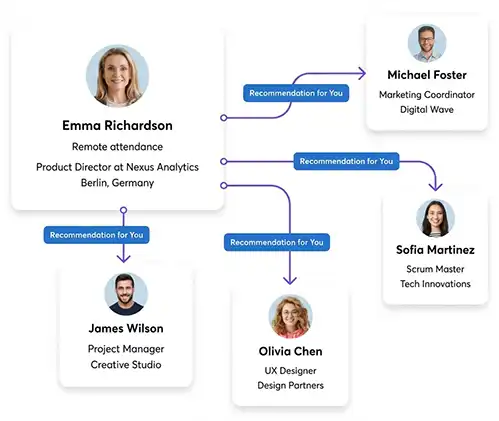
perfis recomendados
Apresentação de recomendações de perfil relevantes
Depois de geradas, as recomendações podem ser apresentadas aos participantes. Isto estimula o envolvimento e a interação no seu evento de networking
- Cada participante vê um conjunto diferente de recomendações de perfil consoante os seus interesses
- À medida que o algoritmo continua a processar dados, as recomendações vão melhorando
- O participante pode marcar algumas recomendações como irrelevantes, o que, por sua vez, ajuda o algoritmo
- Quanto mais ativo for o participante, melhores são as recomendações