
AI pro networking: mýty a realita
Opravdu, mnoho networkingových aplikací deklaruje AI matchmaking nebo smart networking, ale za tím mohou stát velmi různé úrovně skutečné inteligence – od banálního třídění podle tagů až po skutečně adaptivní doporučení s prvky strojového učení.
Rozeberme to po úrovních – od jednoduchého k pokročilému, s příklady možných vzorců a logiky.
🧩 1. "AI" na úrovni filtrování a průniku tagů (90 % reálných případů)
Jak to funguje:
-
Účastníci uvádějí zájmy, odvětví, pozici, cíle (například "hledám partnery ve fintechu").
-
Algoritmus prostě počítá počet shod podle tagů nebo kategorií.
Vzorec může být:
$$\text{score}(A,B) = \frac{|T_A \cap T_B|}{|T_A \cup T_B|}$$
kde \(T_A,\,T_B\) – množiny zájmů účastníků \(A\) a \(B\).
Poté třídění podle score a zobrazení „top-5“ doporučení.
Co se nazývá
"AI":
– "Semantic matching" (ale ve skutečnosti jen synonymizace tagů přes Word2Vec nebo GloVe)
– "Interest similarity" (podle embeddingů slov zájmů)
👉 Realita: algoritmus funguje stabilně, ale ne „inteligentně“ – jen protíná pole.
🤖 2. "Smart" algoritmy na embeddingech (Embedding-based similarity)
Jak je to uspořádáno:
-
Každý účastník je reprezentován jako vektor příznaků (skills, cíle, popis profilu, firma, témata).
-
Model (například Sentence-BERT) převádí text profilu do číselného prostoru.
-
Pak se hledají nejbližší podle kosinové podobnosti.
Vzorec:
$$\text{similarity}(A,B) = \frac{v_A \cdot v_B}{\|v_A\| \, \|v_B\|}$$
(kosinová podobnost mezi embedding vektory)
Plus: Lze najít „sémanticky blízké“ lidi, i když nepoužívají stejná slova.
Mínus: Vyžaduje kvalitní texty a výpočetní výkon.
🧠 3. "Behavioral AI-matching" (vyskytuje se méně často)
Jak to funguje:
-
Systém sbírá chování uživatele: s kým komunikoval, koho lajkoval, koho přeskočil, které schůzky potvrdil.
-
Poté trénuje doporučovací model (jako Netflix):
-
Collaborative filtering (podobní uživatelé – podobná doporučení)
-
Nebo Reinforcement learning (optimalizace pomocí metrik odezvy)
-
Vzorec (příklad maticové faktorizace):
$$\hat{r}_{ij} = p_i^{T} q_j$$
kde \(p_i\) – vektor preferencí uživatele \(i\) a \(q_j\) – vektor charakteristik jiného účastníka.
Čím vyšší \(\hat{r}_{ij}\), tím vyšší „kompatibilita“.
Realita: Velmi vzácný případ, protože je potřeba hodně dat, aby to fungovalo.
🎩 4. "Kouzlo marketingu"
Některé platformy prostě dělají:
-
Náhodný výběr z těch, se kterými ses ještě neviděl;
-
Nebo filtrují podle města/odvětví;
-
A do popisu funkce přidají „AI powered“.
Kontrola je jednoduchá:
– Pokud v rozhraní není možnost uvést cíle/zájmy nebo se neshromažďují údaje o interakcích – „AI“ je tam fiktivní.
– Pokud jsou doporučení vždy šablonovitá a opakují se – pravděpodobně jde o obyčejný filtr podle tagů.
💡 Příklady skutečných platforem:
| Platforma | Co deklarují | Co je ve skutečnosti |
|---|---|---|
| Brella | AI matchmaking | Tag overlap + Semantic matching |
| Grip | AI-powered networking | Embeddings + Interest weighting |
| Swapcard | Smart recommendations | Tag matching + Simple ML weighting |
| MeetingMojo / Whova | Smart search | Filtrování a třídění |
| Zerista / Bizzabo | Intelligent matches | Smíšený systém (tagy + analýza textu) |
AI-matching pro konference – technická dokumentace
Sestaveno z popisu architektury, algoritmů a API, které ukazují realistickou implementaci smart-matchingu pro aplikaci konferencí.
Stručný obsah
- Úrovně implementace „AI“: od jednoduchých tagů po behaviorální modely.
- Hybridní vzorec skórování a konkrétní signály (tag, embedding, role, goal, behavior).
- Pseudokód implementace a číselný příklad výpočtu score.
- Schéma DB (PostgreSQL), tabulky a API-endpointy.
- Architektura: Matching Service, AI Layer (embeddings + FAISS) a cachování.
1. Úrovně „AI“ v networkingových aplikacích
Níže – přehled realistických úrovní, které se vyskytují u dodavatelů:
1. Filtrování / průnik tagů
Jeden z nejrozšířenějších přístupů: účastníci uvádějí tagy/zájmy; platforma počítá shody (například Jaccard) a třídí podle tohoto ukazatele.
Vzorec (Jaccard): S_tag = |T_A ∩ T_B| / |T_A ∪ T_B|
2. Embeddingy a kosinová podobnost
Profily se převádějí do vektorového prostoru (Sentence-BERT, USE) a hledají se nejbližší sousedé podle kosinové míry.
Vzorec: S_embed = (v_A · v_B) / (||v_A|| ||v_B||)
3. Behaviorální modely
Využívají data o interakcích (lajky, schůzky, zobrazení) a staví collaborative filtering, maticovou faktorizaci nebo graph embeddings.
Vyžaduje dostatečný objem dat, proto se vyskytuje méně často.
4. Marketingová „AI-magie“
Některé platformy zjednodušují – používají randomizaci nebo čisté filtrování, ale funkci označují jako „AI“. Ověřovat podle UI a přítomnosti textových signálů/chování.
2. Hybridní vzorec skórování (koncept)
Spojujeme signály s vahami. Obecný vzorec:
Zde σ – normalizace (například sigmoida) pro převedení výsledku do (0,1).
Signály (popis)
- \(S_{\text{tag}}\) – podobnost podle tagů (Jaccard nebo weighted overlap);
- \(S_{\text{embed}}\) – kosinová podobnost embeddingů (normalizujeme do [0,1]);
- \(S_{\text{role}}\) – matice kompatibility rolí (například founder ↔ investor = 0.9);
- \(S_{\text{goal}}\) – shoda cílů (hledám / nabízím);
- \(S_{\text{behavior}}\) - collaborative signal (kdo lajkoval/domlouval schůzky podobným uživatelům);
- \(C_{\text{conflict}}\) – penalizace (například stejný e-mail/firma → vyloučení nebo silná penalizace);
3. Konkrétní vzorce signálů
3.1 Tag similarity (Jaccard)
$$S_{\text{tag}}(A, B) = \frac{|T_A \cap T_B|}{|T_A \cup T_B|}$$
3.2 Embedding similarity (cosine)
$$S_{\text{embed}}(A, B) = \frac{v_A \cdot v_B}{\|v_A\| \, \|v_B\|}$$
Hodnota v [-1,1] → normalizujeme do [0,1] jako (x+1)/2.
3.3 Role compatibility
Matice kompatibility rolí: předem zadaná tabulka hodnot v rozsahu [0,1].
3.4 Goal match
Jednoduchá logika shody cílů (například „hledám partnery“ vs „nabízím partnerství“ → 1.0).
3.5 Behavioral signal
Příklad: využití informací o tom, které profily si vybrali podobní uživatelé.
Nejjednodušší signatura: $$S_{\text{behavior}}(A, B) = \frac{\#\,\text{users similar to } A \text{ who connected to } B}{\#\,\text{users similar to } A}$$
4. Normalizace a spojení
Každý signál normalizujeme do [0,1]. Poté kombinujeme podle vah a aplikujeme sigmoidní normalizaci:
$$ \text{raw} = \sum_i w_i S_i - w_6 C $$
$$ \text{score} = \text{sigmoid}\left( \alpha \cdot (\text{raw} - \beta) \right) $$
5. Číselný příklad
Nechť:
- \(T_A = \{\text{fintech}, \text{payments}, \text{API}\}\)
- \(T_B = \{\text{payments}, \text{banking}\}\)
- \(S_{\text{tag}} = \frac{|T_A \cap T_B|}{|T_A \cup T_B|} = \frac{1}{4} = 0.25\)
- \(\text{cosine}(v_A, v_B) = 0.6 \Rightarrow S_{\text{embed}} = \frac{0.6 + 1}{2} = 0.8\)
- \(S_{\text{role}} = 0.7,\; S_{\text{goal}} = 1.0,\; S_{\text{behavior}} = 0.0,\; C_{\text{conflict}} = 0\)
Váhy: \(w_{\text{tag}}=0.15,\; w_{\text{embed}}=0.35,\; w_{\text{role}}=0.15,\; w_{\text{goal}}=0.25,\; w_{\text{behavior}}=0.05\)
\[ \text{raw} = 0.15 \cdot 0.25 + 0.35 \cdot 0.8 + 0.15 \cdot 0.7 + 0.25 \cdot 1.0 + 0.05 \cdot 0 = 0.6725 \] \[ \text{score} = \sigma(8 \cdot (0.6725 - 0.5)) \approx \sigma(1.38) \approx 0.8 \]
Celkem: B – výborný kandidát (\(\text{score} \approx 0.8\)).
6. Praktické postupy a vylepšení
- Cold start: oblíbené profily + signály pouze z obsahu.
- Trénování vah: A/B testování a supervised learning (logistická regrese, LightGBM) podle štítků užitečnosti.
- Rychlost: předpočítávat embeddingy, ANN (FAISS/pgvector) → candidate generation + re-rank.
- Interpretovatelnost: zobrazovat důvod shody v UI (společné tagy, shoda cílů).
- Soukromí: možnosti "neúčastnit se", explicitní uvedení, jaká data se používají.
7. API-endpointy (REST)
GET /api/users/{id}– profil a tagy.POST /api/users– vytvoření/aktualizace profilu (spouštěč generování embeddingu).GET /api/matching/{user_id}– vrací top-N doporučených partnerů pro rozhovor (refresh parametr pro přepočet).GET /api/matching/search– vyhledávání kandidátů podle filtrů (tags, roles, location).POST /api/interactions– registrace like/skip/meeting_confirmed (zpětná vazba pro model).
8. Architektura a tok dat
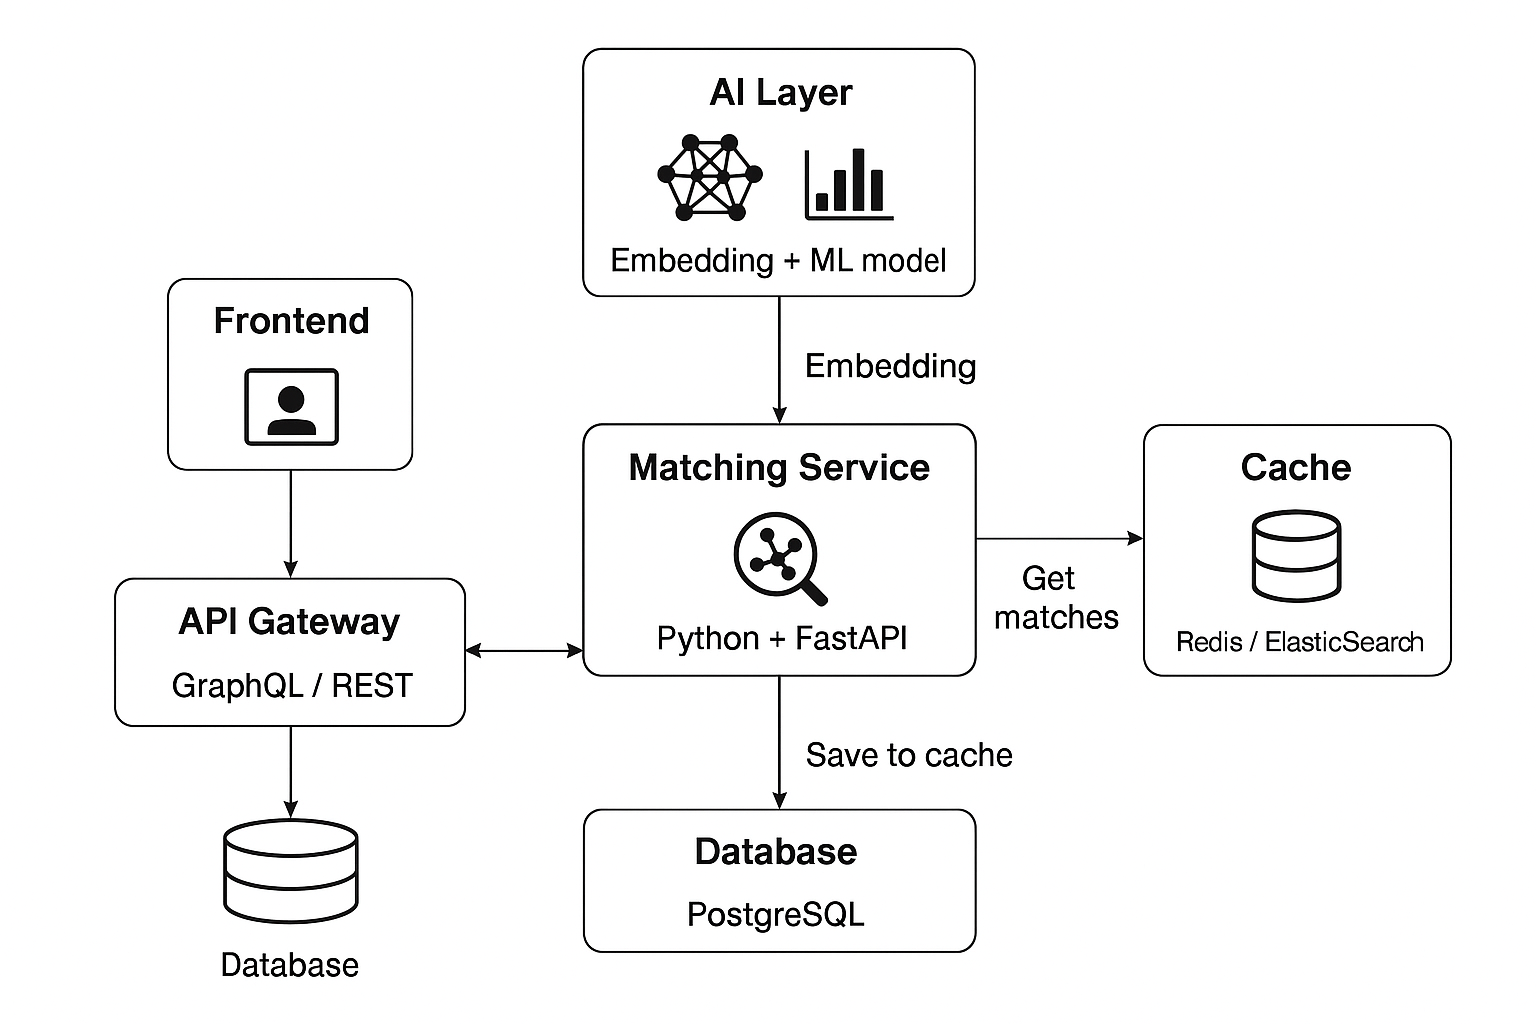
Stručně: Frontend ↔ API Gateway ↔ Matching Service ↔ Database / AI Layer / Cache.
Architektonický diagram
Aktualizovaný flowchart: Matching Service, AI Layer (embeddings + ML), DB, Cache.
9. Pipeline ML na pozadí
- daily_batch.py – sbírá interactions, aktualizuje latent vectors.
- retrain_embeddings.py – regenerace embeddingů po změně modelu.
- generate_faiss_index.py – staví ANN index pro rychlé top-N dotazy.
10. Doporučení pro MVP a škálování
- Začít s tagy + Jaccard → přidat embeddingy (Sentence-BERT) → ANN (FAISS) + re-rank.
- Cache shod 1–3 hodiny pro snížení zátěže.
- Pro 50k účastníků – pgvector + Redis; >100k - FAISS/Milvus.
A formát, kdybychom byli běžnou službou pro marketéry a laiky:
sběr dat
Sběr zájmů a preferencí účastníků
Pro vytvoření relevantních doporučení podle profilu je zapotřebí velký objem dat. Účastníci tato data přirozeně shromažďují vyplňováním údajů ve svých profilech a prostým používáním platformy
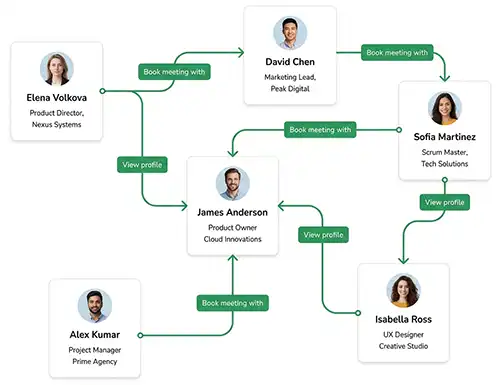
- Účastníci navštěvují profily jeden druhého a spojují se prostřednictvím zpráv a žádostí o schůzky
- To zanechává stopu spojení a vytváří složitou síť interakcí účastníků
- Spolu s daty z jejich profilů jsou tyto informace nepřetržitě předávány našemu algoritmu strojového učení v režimu blízkém reálnému času
analýza dat
Porozumění potřebám účastníků pomocí strojového učení
Při sběru dat je algoritmus zároveň zpracovává. Tento nepřetržitý cyklus mu umožňuje zjistit, co každého účastníka zajímá
- Algoritmus neustále analyzuje chování účastníků a informace v jejich profilech
- Jde o interpretaci dat k pochopení zájmů a cílů každého účastníka
- Když to pochopí, dokáže předpovědět, které profily mohou účastníka zajímat
doporučené profily
Poskytování relevantních doporučení profilů
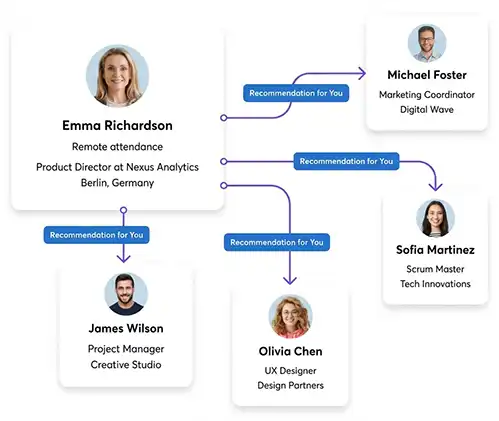
Po vytvoření doporučení je lze představit účastníkům. To podněcuje zapojení a interakci v rámci vaší networkingové akce
- Každý účastník vidí jinou sadu doporučení profilů podle svých zájmů
- Jak algoritmus dále zpracovává data, doporučení se zlepšují
- Účastník může některá doporučení označit jako nerelevantní, což zase pomáhá algoritmu
- Čím aktivnější účastník, tím lepší doporučení