
AI pentru networking: mituri și realitate
Într-adevăr, multe aplicații de networking pretind AI matchmaking sau smart networking, dar în spatele acestora se pot afla niveluri foarte diferite de inteligență reală - de la o simplă sortare pe etichete, până la recomandări cu adevărat adaptive cu elemente de învățare automată.
Să analizăm pe niveluri - de la simplu la avansat, cu exemple de formule și logică posibile.
🧩 1. „AI” la nivel de filtrare și intersecție de etichete (90% din cazurile reale)
Cum funcționează:
-
Participanții indică interese, industria, funcția, obiectivele (de exemplu, „caut parteneri în fintech”).
-
Algoritmul pur și simplu numără câte etichete sau categorii se suprapun.
Formula poate fi:
$$\text{score}(A,B) = \frac{|T_A \cap T_B|}{|T_A \cup T_B|}$$
unde \(T_A,\,T_B\) - mulțimile de interese ale participanților \(A\) și \(B\).
Apoi se face sortarea după score și se afișează „top 5” recomandări.
Ce se numește
„AI”:
– „Semantic matching” (dar în realitate e doar sinonimizare a etichetelor prin Word2Vec sau GloVe)
– „Interest similarity” (după embedding-ul cuvintelor de interes)
👉 Realitatea: algoritmul funcționează stabil, dar nu „inteligent” - pur și simplu intersectează câmpuri.
🤖 2. Algoritmi „smart” bazați pe embeddings (Embedding-based similarity)
Cum e construit:
-
Fiecare participant este reprezentat ca un vector de caracteristici (skills, obiective, descrierea profilului, companie, teme).
-
Un model (de exemplu, Sentence-BERT) transformă textul profilului într-un spațiu numeric.
-
Apoi se caută cei mai apropiați după similaritatea cosinus.
Formula:
$$\text{similarity}(A,B) = \frac{v_A \cdot v_B}{\|v_A\| \, \|v_B\|}$$
(similaritatea cosinus între vectorii embedding)
Plus: Se pot găsi
persoane „apropiate semantic”, chiar dacă nu folosesc aceleași cuvinte.
Minus: Necesită texte de calitate și putere
de calcul.
🧠 3. „Behavioral AI-matching” (mai rar întâlnit)
Cum funcționează:
-
Sistemul colectează comportamentul utilizatorului: cu cine a vorbit, pe cine a apreciat, pe cine a omis, ce întâlniri a confirmat.
-
Apoi antrenează un model de recomandare (ca la Netflix):
-
Collaborative filtering (utilizatori similari - recomandări similare)
-
Sau Reinforcement learning (optimizare pe baza metricilor de răspuns)
-
Formulă (exemplu de factorizare matriceală):
$$\hat{r}_{ij} = p_i^{T} q_j$$
unde \(p_i\) - vectorul preferințelor utilizatorului \(i\), iar \(q_j\) - vectorul caracteristicilor celuilalt participant.
Cu cât \(\hat{r}_{ij}\) e mai mare, cu atât „compatibilitatea” e mai mare.
Realitate: Situație foarte rară, pentru că sunt necesare multe date pentru ca acest lucru să funcționeze.
🎩 4. „Magia marketingului”
Unele platforme pur și simplu fac:
-
O selecție aleatorie din cei care nu s-au mai văzut cu tine;
-
Sau filtrează după oraș/industrie;
-
Și adaugă „AI powered” în descrierea funcției.
Verificarea este simplă:
– Dacă în interfață nu există posibilitatea de a indica obiective/interese sau nu se colectează date despre interacțiuni -
înseamnă că „AI”-ul de acolo este fictiv.
– Dacă recomandările sunt mereu șablonate și se repetă - probabil este un simplu filtru pe etichete.
💡 Exemple de platforme reale:
| Platformă | Ce pretinde | Ce este în realitate |
|---|---|---|
| Brella | AI matchmaking | Tag overlap + Semantic matching |
| Grip | AI-powered networking | Embeddings + Interest weighting |
| Swapcard | Smart recommendations | Tag matching + Simple ML weighting |
| MeetingMojo / Whova | Smart search | Filtrare și sortare |
| Zerista / Bizzabo | Intelligent matches | Sistem mixt (etichete + analiză textuală) |
AI-matching pentru conferințe - documentație tehnică
Compilat din descrierea arhitecturii, algoritmilor și API-urilor, care demonstrează o implementare realistă a smart‑matching-ului pentru o aplicație de conferințe.
Rezumat
- Nivelurile de implementare „AI”: de la etichete simple la modele comportamentale.
- Formulă hibridă de scoring și semnale concrete (tag, embedding, role, goal, behavior).
- Pseudocod de implementare și un exemplu numeric de calcul al score-ului.
- Schema bazei de date (PostgreSQL), tabele și endpoint-uri API.
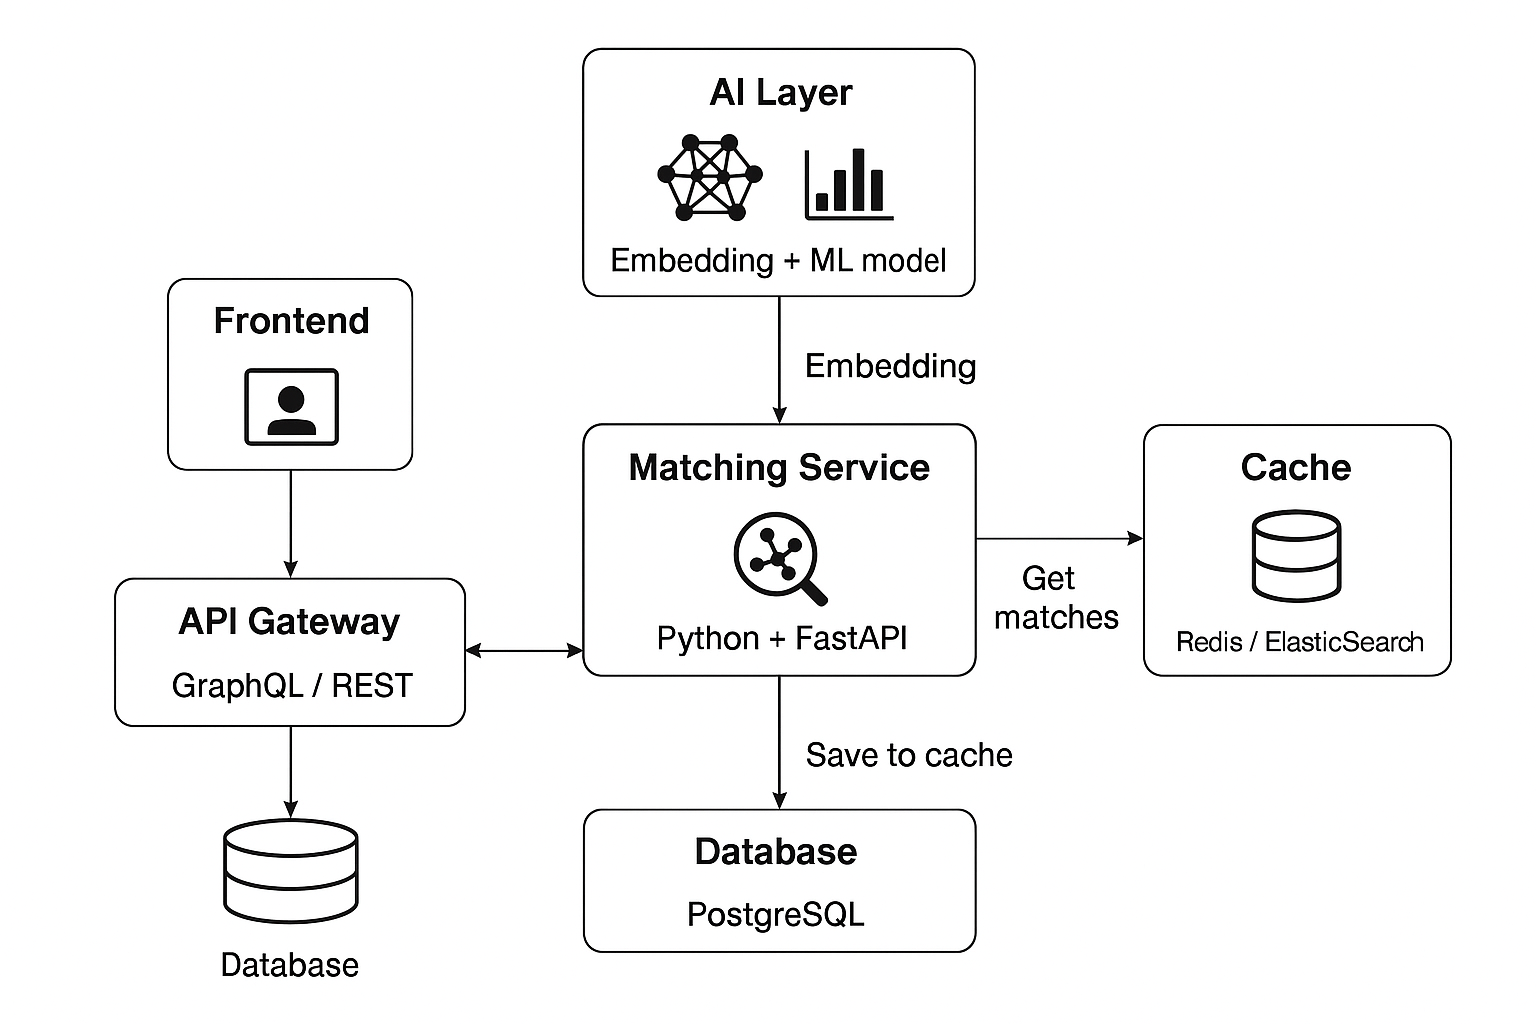
- Arhitectură: Matching Service, AI Layer (embeddings + FAISS) și caching.
1. Nivelurile de „AI” în aplicațiile de networking
Mai jos - un rezumat al nivelurilor realiste întâlnite la furnizori:
1. Filtrare / intersecție de etichete
Una dintre cele mai răspândite abordări: participanții indică etichete/interese; platforma numără suprapunerile (de exemplu, Jaccard) și sortează după acest indicator.
Formulă (Jaccard): S_tag = |T_A ∩ T_B| / |T_A ∪ T_B|
2. Embeddings și similaritate cosinus
Profilurile sunt transformate într-un spațiu vectorial (Sentence‑BERT, USE) și se caută cei mai apropiați vecini după măsura cosinus.
Formulă: S_embed = (v_A · v_B) / (||v_A|| ||v_B||)
3. Modele comportamentale
Folosesc date de interacțiune (aprecieri, întâlniri, vizualizări) și construiesc collaborative filtering, factorizare matriceală sau graph embeddings.
Necesită un volum suficient de date, de aceea se întâlnesc mai rar.
4. „Magia AI” de marketing
Unele platforme simplifică - folosesc randomizare sau o simplă filtrare, dar marchează funcția ca „AI”. Se verifică prin UI și prin prezența semnalelor textuale/comportamentale.
2. Formulă hibridă de scoring (concept)
Combinăm semnalele cu ponderi. Formula generală:
Aici σ - normalizare (de exemplu, sigmoidă) pentru a aduce rezultatul în (0,1).
Semnale (descriere)
- \(S_{\text{tag}}\) - similaritate pe etichete (Jaccard sau weighted overlap);
- \(S_{\text{embed}}\) - similaritate cosinus a embeddings (normalizată în [0,1]);
- \(S_{\text{role}}\) - matricea de compatibilitate a rolurilor (de exemplu, founder ↔ investor = 0.9);
- \(S_{\text{goal}}\) - suprapunerea obiectivelor (caut / ofer);
- \(S_{\text{behavior}}\) - collaborative signal (cine a apreciat/a stabilit întâlniri cu utilizatori similari);
- \(C_{\text{conflict}}\) - penalizări (de exemplu, același email/companie → exclus sau penalizare puternică);
3. Formule concrete ale semnalelor
3.1 Tag similarity (Jaccard)
$$S_{\text{tag}}(A, B) = \frac{|T_A \cap T_B|}{|T_A \cup T_B|}$$
3.2 Embedding similarity (cosine)
$$S_{\text{embed}}(A, B) = \frac{v_A \cdot v_B}{\|v_A\| \, \|v_B\|}$$
Valoarea din [-1,1] → se normalizează în [0,1] ca (x+1)/2.
3.3 Role compatibility
Matricea de compatibilitate a rolurilor: un tabel de valori predefinit în intervalul [0,1].
3.4 Goal match
Logică simplă de suprapunere a obiectivelor (de exemplu, „caut parteneri” vs „ofer parteneriat” → 1.0).
3.5 Behavioral signal
Exemplu: folosirea informațiilor despre ce profiluri au ales utilizatori similari.
Cea mai simplă semnătură: $$S_{\text{behavior}}(A, B) = \frac{\#\,\text{users similar to } A \text{ who connected to } B}{\#\,\text{users similar to } A}$$
4. Normalizare și combinare
Fiecare semnal se normalizează în [0,1]. Apoi combinăm cu ponderi și aplicăm normalizarea sigmoidă:
$$ \text{raw} = \sum_i w_i S_i - w_6 C $$
$$ \text{score} = \text{sigmoid}\left( \alpha \cdot (\text{raw} - \beta) \right) $$
5. Exemplu numeric
Fie:
- \(T_A = \{\text{fintech}, \text{payments}, \text{API}\}\)
- \(T_B = \{\text{payments}, \text{banking}\}\)
- \(S_{\text{tag}} = \frac{|T_A \cap T_B|}{|T_A \cup T_B|} = \frac{1}{4} = 0.25\)
- \(\text{cosine}(v_A, v_B) = 0.6 \Rightarrow S_{\text{embed}} = \frac{0.6 + 1}{2} = 0.8\)
- \(S_{\text{role}} = 0.7,\; S_{\text{goal}} = 1.0,\; S_{\text{behavior}} = 0.0,\; C_{\text{conflict}} = 0\)
Ponderi: \(w_{\text{tag}}=0.15,\; w_{\text{embed}}=0.35,\; w_{\text{role}}=0.15,\; w_{\text{goal}}=0.25,\; w_{\text{behavior}}=0.05\)
\[ \text{raw} = 0.15 \cdot 0.25 + 0.35 \cdot 0.8 + 0.15 \cdot 0.7 + 0.25 \cdot 1.0 + 0.05 \cdot 0 = 0.6725 \] \[ \text{score} = \sigma(8 \cdot (0.6725 - 0.5)) \approx \sigma(1.38) \approx 0.8 \]
În total: B - candidat excelent (\(\text{score} \approx 0.8\)).
6. Tehnici practice și îmbunătățiri
- Cold start: profiluri populare + semnale content-only.
- Antrenarea ponderilor: testare A/B și supervised learning (regresie logistică, LightGBM) pe baza etichetelor de utilitate.
- Viteză: precalcularea embeddings, ANN (FAISS/pgvector) → candidate generation + re-rank.
- Interpretabilitate: afișarea motivului potrivirii în UI (etichete comune, obiective care se suprapun).
- Confidențialitate: opțiuni „nu particip”, indicarea explicită a datelor folosite.
7. Endpoint-uri API (REST)
GET /api/users/{id}- profil și etichete.POST /api/users- creare/actualizare profil (declanșează generarea embedding-ului).GET /api/matching/{user_id}- returnează top‑N interlocutori recomandați (parametrul refresh pentru recalculare).GET /api/matching/search- căutare candidați după filtre (tags, roles, location).POST /api/interactions- înregistrarea like/skip/meeting_confirmed (feedback pentru model).
8. Arhitectură și flux de date
În rezumat: Frontend ↔ API Gateway ↔ Matching Service ↔ Database / AI Layer / Cache.
Diagrama arhitecturii
Flowchart actualizat: Matching Service, AI Layer (embeddings + ML), DB, Cache.
9. Pipeline ML în fundal
- daily_batch.py - colectează interactions, actualizează latent vectors.
- retrain_embeddings.py - regenerarea embeddings după schimbarea modelului.
- generate_faiss_index.py - construiește un index ANN pentru interogări top‑N rapide.
10. Recomandări pentru MVP și scalare
- Se începe cu etichete + Jaccard → se adaugă embeddings (Sentence‑BERT) → ANN (FAISS) + re‑rank.
- Cache pentru potriviri de 1–3 ore, pentru a reduce încărcarea.
- Pentru 50k participanți - pgvector + Redis; >100k - FAISS/Milvus.
Și formatul dacă am fi un serviciu obișnuit pentru marketeri și publicul larg:
colectare de date
Colectarea intereselor și preferințelor participanților
Pentru a genera recomandări relevante de profil este nevoie de un volum mare de date. Participanții colectează aceste date în mod natural, completându-și profilurile și folosind pur și simplu platforma
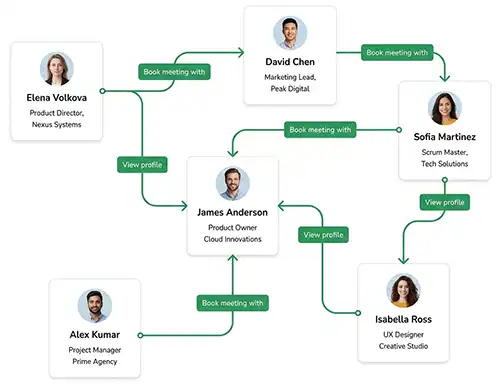
- Participanții vizitează profilurile unii altora și comunică între ei prin mesaje și cereri de întâlniri
- Acest lucru lasă o traiectorie de conexiuni și creează o rețea complexă de interacțiuni între participanți
- Împreună cu datele profilurilor lor, aceste informații sunt transmise continuu algoritmului nostru de învățare automată, aproape în timp real
analiza datelor
Înțelegerea nevoilor participanților cu ajutorul învățării automate
Pe măsură ce colectează datele, algoritmul le procesează simultan. Acest ciclu continuu îi permite să determine ce îl interesează pe fiecare participant
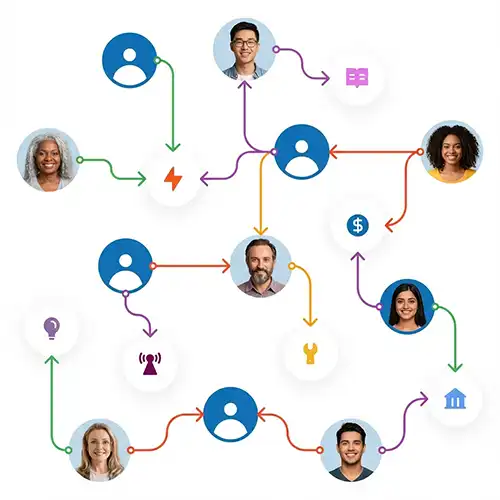
- Algoritmul analizează constant comportamentul participanților și informațiile din profilurile lor
- Aceasta este interpretarea datelor pentru a înțelege interesele și obiectivele fiecărui participant
- Înțelegând acest lucru, va putea prezice ce profiluri ar putea fi interesante pentru participant
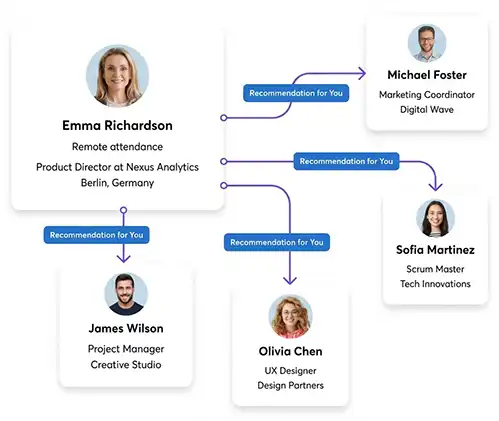
profiluri recomandate
Oferirea unor recomandări de profil relevante
După formarea recomandărilor, acestea pot fi prezentate participanților. Acest lucru stimulează implicarea și interacțiunea în cadrul evenimentului dumneavoastră de networking
- Fiecare participant vede un set diferit de recomandări de profil, în funcție de propriile interese
- Pe măsură ce algoritmul continuă să proceseze date, recomandările se îmbunătățesc
- Participantul poate marca unele recomandări ca fiind nerelevante, ceea ce, la rândul său, ajută algoritmul
- Cu cât participantul este mai activ, cu atât recomandările sunt mai bune